Synthetische Daten: Ihr Nutzen für bessere KI-Modelle
Daten spielen selbstverständlich eine entscheidende Rolle für Unternehmen, die ihre Prozesse digitalisieren. Doch während der Bedarf an qualitativ hochwertigen und großen Datenmengen steigt, stoßen wir häufig auf Herausforderungen wie Datenschutzbeschränkungen und einen Mangel an ausreichenden Daten für spezialisierte Aufgaben. Hier erweist sich das Konzept synthetischer Daten als wegweisende Lösung.
Warum synthetische Daten?
- Datenschutz und Sicherheit: In Bereichen, in denen der Datenschutz eine große Rolle spielt, etwa im Gesundheitswesen oder im Finanzsektor, bieten zusätzliche Daten eine Möglichkeit, sensible Informationen zu schützen. Da die Daten nicht direkt von einzelnen Personen stammen, wird das Risiko von Datenschutzverletzungen erheblich reduziert.
- Verfügbarkeit und Vielfalt: Bestimmte Datensätze, insbesondere in Nischenbereichen, können rar sein. Synthetische Daten können diese Lücken schließen, indem sie Daten generieren, die sonst nur schwer zu beschaffen wären.
- Training und Validierung: In der Welt der KI und des maschinellen Lernens werden große Datenmengen benötigt, um Modelle effektiv zu trainieren. Synthetische Daten können verwendet werden, um Trainingsdatensätze zu erweitern und die Leistung dieser Modelle zu verbessern.
Anwendungen
- Gesundheitswesen: Durch die Erstellung synthetischer Patientenakten können Forschende Krankheitsmuster untersuchen, ohne echte Patientendaten zu verwenden, wodurch der Datenschutz gewährleistet bleibt.
- Autonome Fahrzeuge: Für das Testen und Trainieren selbstfahrender Autos werden große Mengen an Verkehrsdaten benötigt. Synthetische Daten können realistische Verkehrsszenarien generieren, die dazu beitragen, die Sicherheit und Effizienz dieser Fahrzeuge zu verbessern.
- Finanzmodellierung: Im Finanzsektor können synthetische Daten verwendet werden, um Markttrends zu simulieren und Risikoanalysen durchzuführen, ohne sensible Finanzinformationen offenzulegen.
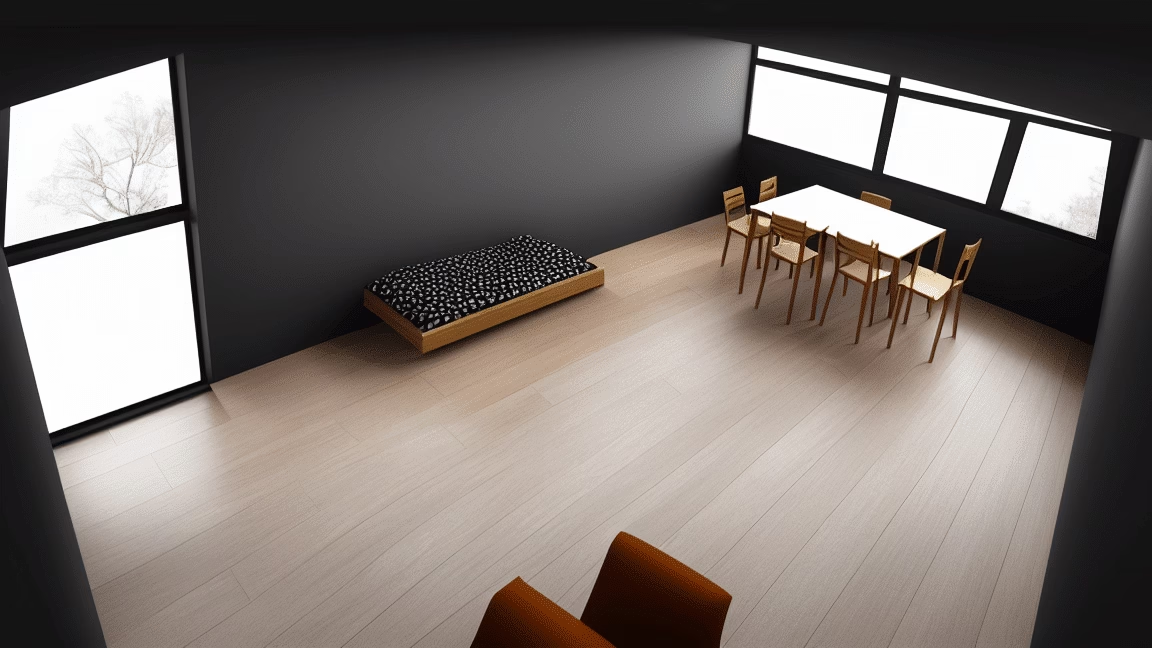
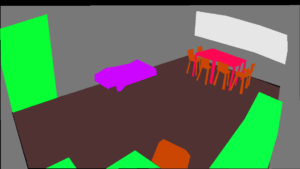
Beispiel: Ein synthetisch generierter Raum
Herausforderungen und Überlegungen
Obwohl sie also viele Vorteile bieten, gibt es auch Herausforderungen. Die Qualität und Genauigkeit dieser Daten sicherzustellen, ist entscheidend. Ungenaue synthetische Datensätze können nämlich zu irreführenden Ergebnissen und Entscheidungen führen. Darüber hinaus ist es wichtig, ein Gleichgewicht zwischen der Nutzung synthetischer Daten und realer Daten zu finden, um ein vollständiges und präzises Bild zu erhalten. Außerdem können zusätzliche Daten verwendet werden, um Verzerrungen (Bias) in einem Datensatz zu verringern. Large Language Models verwenden generierte Daten, weil sie das Internet schlichtweg bereits ausgelesen haben und noch mehr Trainingsdaten benötigen, um besser zu werden.
Fazit
Synthetische Daten sind eine vielversprechende Entwicklung in der Welt der Datenanalyse und maschinelles Lernen. Sie bieten eine Lösung für Datenschutzprobleme und verbessern die Verfügbarkeit von Daten. Außerdem sind sie für das Training fortschrittlicher Algorithmen von unschätzbarem Wert. Während wir diese Technologie weiterentwickeln und integrieren, ist es entscheidend, die Qualität und Integrität der Daten zu gewährleisten, damit wir das volle Potenzial synthetischer Daten ausschöpfen können.
Benötigen Sie Unterstützung bei der effektiven Anwendung von KI? Nutzen Sie unsere Beratungsleistungen


